Worum es geht
Bis hierher hast du Bilder deiner Figur und eine Stimme, die jeden Text spricht. Jetzt kommt beides zusammen: Ein Videomodell nimmt das Startbild als ersten Moment und lässt die Figur zur Tonspur sprechen – Lippen, Kopf, Blinzeln, Hände. Der Text steckt nur im Ton; das Modell hört zu und bewegt den Mund passend dazu.
Das Werkzeug dafür heißt InfiniteTalk. Es ist eine Erweiterung für das offene Videomodell Wan 2.1 und läuft direkt in ComfyUI. „Infinite“ heißt es, weil es nicht bei wenigen Sekunden aufhört: Es erzeugt das Video in Abschnitten und setzt sie nahtlos aneinander, so lang wie der Ton.
Was vorher passiert ist
In Lektion A4 ist das Startbild entstanden: Hochformat 768 × 1344, Brustbild, Blick in die Kamera, Mund geschlossen.
In Lektion A5 hat die Figur ihre Stimme bekommen; sprechen.py hat einen Satz gesprochen und vorn und hinten je eine
Sekunde Stille angehängt. Beides zusammen ist alles, was InfiniteTalk braucht.
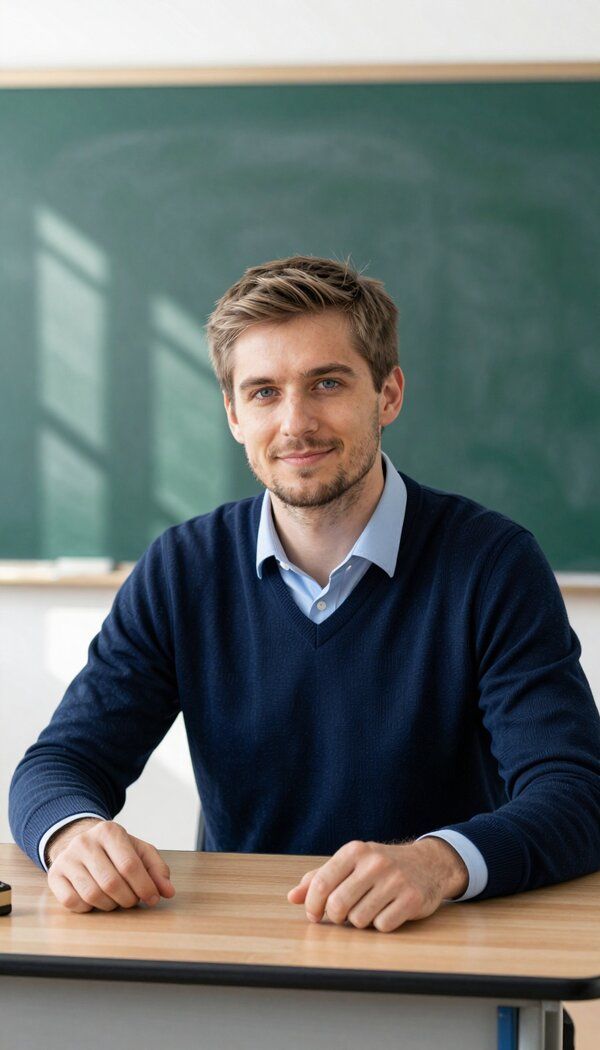
Ein gutes Startbild: frontal, ruhige Hände, Mund geschlossen. Das Modell beginnt genau hier.
KI-generiert.Der Ablauf
1. Einmal die Modelle holen
InfiniteTalk braucht sechs Dateien, zusammen rund 28 GB: das Videomodell Wan 2.1 (Image-to-Video, 14 Milliarden
Parameter, in 8 Bit), ein LoRA, das die Berechnung auf 6 Schritte verkürzt, einen Textencoder, den VAE, die
InfiniteTalk-Erweiterung selbst und einen Audio-Encoder, der aus dem Ton herausliest, welche Laute gerade kommen.
skripte/einrichten/sprechclip.py lädt sie nach modelle/ und verlinkt sie in ComfyUI. Zum Schluss prüft es, ob die
laufende ComfyUI-Version InfiniteTalk kennt.
2. Die Länge aus dem Ton
Das Video hat 25 Bilder pro Sekunde und ist genau so lang wie die Tonspur. InfiniteTalk rechnet in Abschnitten zu je 81 Bildern. Jeder weitere Abschnitt übernimmt die letzten 9 Bilder des vorigen als Bewegungsvorlage, damit die Übergänge nicht springen. Für den Clip der Startseite:
11,6 s Ton × 25 Bilder/s → 290 Bilder in 4 Abschnitten zu je 81 (Überlappung 9)3. Ein Auftrag an ComfyUI
sprechclip.py legt Startbild und Ton in den Clip-Ordner, kopiert beide in den Eingabeordner von ComfyUI, gibt den
Grafikspeicher frei und schreibt dann einen einzigen Auftrag (auftrag_sprechclip.json): alle Abschnitte
hintereinander, am Ende zu einem Video mit Ton verbunden. Diesen Auftrag schickt comfy.py ab, wartet und holt
clip.mp4 ab. Auf einer RTX 3090 dauert das gut eine Minute je Sekunde Video.
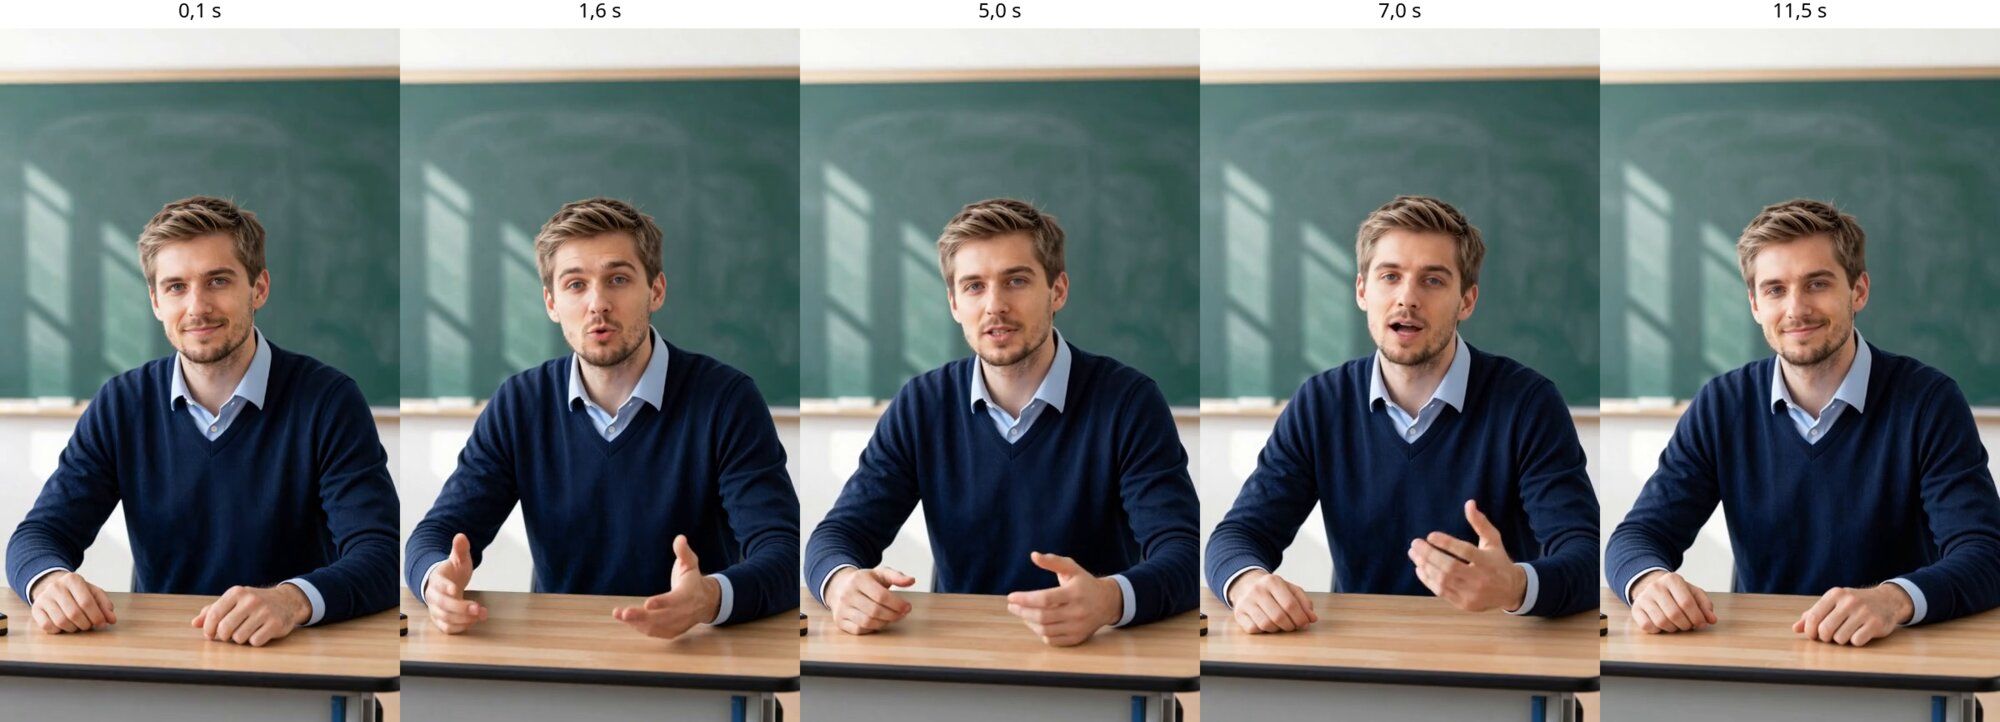
Der Clip der Startseite im Verlauf. Bei 0,1 und 11,5 Sekunden ist Stille: Er sitzt ruhig da, der Mund ist zu. Dazwischen spricht er und bewegt die Hände.
KI-generiert.Von Hand: der ganze Weg
Alle Befehle laufen im Kursordner. Mit -v gibt jedes Skript die Befehle aus, die es ausführt; mit --zeigen nur
die Befehle, ohne etwas zu tun. Nach jedem Lauf liegt protokoll_sprechclip.sh im Ergebnisordner – genau diese Befehle der Reihe
nach, zum Nachlesen oder erneut Ausführen.
Im Terminal, im Kursordner
# 1. Einmalig: die Modelle für InfiniteTalk (rund 28 GB)
python3 skripte/einrichten/sprechclip.py -v

# 2. Der Clip: Startbild aus A4, Tonspur aus A5 – rund eine Minute Rechenzeit je Sekunde Video
python3 skripte/sprechclip.py szenen/pult.png clips/probe/stimme.wav --name probe -v

# 3. Ansehen und prüfen
mpv clips/probe/clip.mp4
python3 skripte/pruefen.py A6
So sieht der Lauf mit -v aus (der lange JSON-Auftrag gekürzt):
# 11.6 s Ton × 25 Bilder/s → 290 Bilder in 4 Abschnitten zu je 81 (Überlappung 9)
# Startbild und Tonspur in den Clip-Ordner
▸ mkdir -p clips/probe
▸ cp szenen/pult.png clips/probe/startbild.png
# Eingaben für ComfyUI bereitlegen
▸ cp clips/probe/startbild.png werkzeuge/ComfyUI/input/sprechclip_probe.png
▸ cp clips/probe/stimme.wav werkzeuge/ComfyUI/input/sprechclip_probe.wav
# Grafikspeicher freigeben – das Videomodell braucht die ganze Karte
▸ python3 skripte/werkzeuge/comfy.py frei
# Der ComfyUI-Auftrag: InfiniteTalk in Abschnitten, dann Video mit Ton
▸ cat > clips/probe/auftrag_sprechclip.json <<'EOF'
{ "unet": { "class_type": "UNETLoader", … }, … }
EOF
# Senden, warten (auf einer RTX 3090 gut eine Minute je Sekunde Video), Ergebnis holen
▸ python3 skripte/werkzeuge/comfy.py ausfuehren clips/probe/auftrag_sprechclip.json --ziel clips/probe/clip.mp4
Den Auftrag kannst du auch ohne das Skript abschicken – er ist ein ComfyUI-Graph im API-Format:
curl -s -X POST http://127.0.0.1:8188/prompt -H 'Content-Type: application/json' -d "{\"prompt\": $(cat clips/probe/auftrag_sprechclip.json)}".
Entscheidungen
Welches Modell lässt das Bild sprechen?
InfiniteTalk auf Wan 2.1, nicht LTX-2.3
Beide halten das Gesicht stabil. InfiniteTalk bewegt Kopf und Hände natürlicher. LTX-2.3 rechnet in höherer Auflösung (704 × 1280), braucht dafür 23,3 von 24 GB und kodiert den Ton um, sodass man ihn danach wieder durch das Original ersetzen muss.
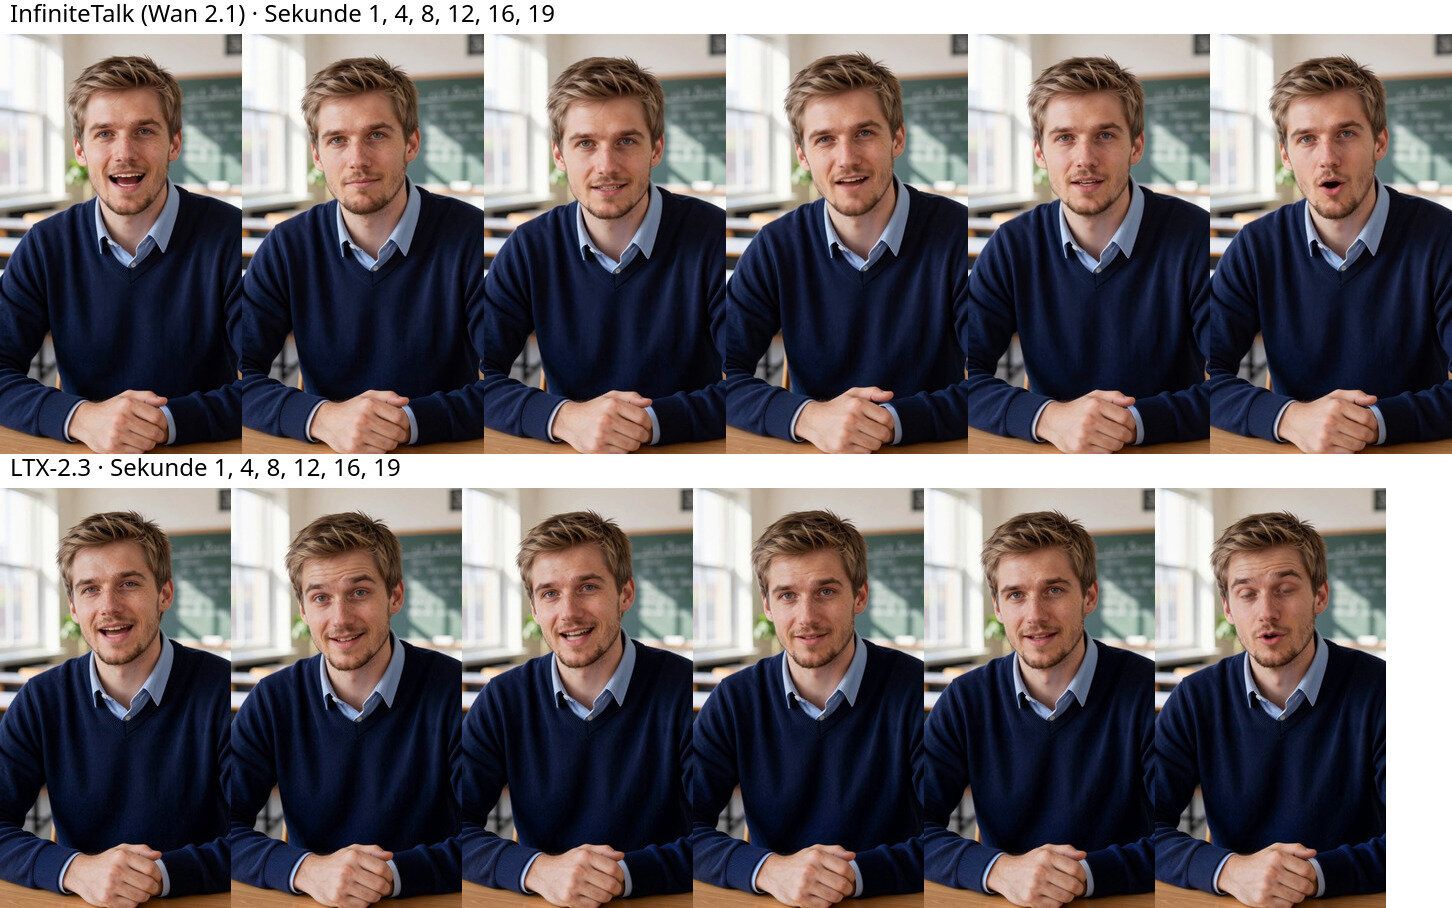
Derselbe Text, dasselbe Startbild. Oben InfiniteTalk, unten LTX-2.3. Den Unterschied sieht man vor allem in Bewegung: Bei InfiniteTalk arbeiten Kopf und Mimik mehr mit.
KI-generiert.Wie viele Schritte je Abschnitt?
6 Schritte mit dem lightx2v-LoRA
Ohne das LoRA braucht Wan 2.1 ein Vielfaches an Schritten und Zeit. Mit dem destillierten LoRA reichen 6 Schritte; die Qualität bleibt für Sprech-Clips gut.
Wie fängt der Clip an und wie hört er auf?
Je 1 Sekunde Stille in der Tonspur
Das Video ist so lang wie der Ton. Mit einer stillen Sekunde vorn und hinten hat die Figur Zeit, ruhig anzufangen und ruhig aufzuhören, mit geschlossenem Mund. Ohne Stille wirkten Anfang und Ende oft abgehackt oder ruckelig.
Fallstricke
Anfang oder Ende wirken abgehackt
Beginnt der Ton sofort mit dem ersten Wort, startet die Figur mitten in der Bewegung. Am Ende reißt der Clip mit dem letzten Laut ab.
LösungTonspur mit je 1 s Stille erzeugen (sprechen.py --stille 1.0, Vorgabe).
Hände machen, was sie wollen
InfiniteTalk bewegt auch die Hände. Liegen sie schon im Startbild unruhig oder halb außerhalb des Bildes, hat das Modell wenig Halt; Finger und Gegenstände am Rand können sich in der Bewegung verformen. Bei der Auswahl des Startbilds deshalb auf ruhige Hände achten.
LösungEin Startbild mit ruhig liegenden Händen wählen; Laptops und Gegenstände am Bildrand vermeiden.
Der Grafikspeicher ist voll
Das Videomodell braucht fast die ganze Karte. Sind noch Bildmodelle aus A4 geladen oder läuft daneben etwa ein Blender-Render, bricht der Auftrag ab oder wird sehr langsam.
LösungVorher comfy.py frei – macht sprechclip.py von selbst; andere GPU-Programme beenden.
ComfyUI kennt WanInfiniteTalkToVideo nicht
Die InfiniteTalk-Knoten gehören zu neueren ComfyUI-Versionen. Ältere Installationen melden beim Abschicken des Auftrags einen unbekannten Knoten.
LösungComfyUI aktualisieren (Lektion A1) und die Prüfung in einrichten/sprechclip.py wiederholen.
Mit KI vereinfacht
Den ganzen Schritt kann der Agent übernehmen: Modelle einrichten, die Länge berechnen, den Auftrag schreiben und abschicken, warten und dir den fertigen Clip nennen. Du entscheidest vorher, welches Startbild und welcher Text es sind, und hinterher, ob der Clip gut genug ist.
Der Agent
- lädt die Modelle für InfiniteTalk und prüft ComfyUI
- legt Startbild und Ton in den Clip-Ordner und gibt den Grafikspeicher frei
- startet den Auftrag und meldet sich, wenn der Clip fertig ist
- legt dir ein paar Einzelbilder als Übersicht hin
Du
- wählst Startbild und Text
- siehst dir den Clip an und entscheidest, ob er bleibt
Mit dem Skill avatar-clip reicht ein Satz an den Agenten:
Mach aus szenen/pult.png und clips/probe/stimme.wav einen Sprech-Clip
und zeig mir fünf Einzelbilder daraus.
Der Skill ist in Vorbereitung und erscheint mit dem Video zu dieser Lektion.
Mit lokalem Qwen: Das Videomodell braucht fast die ganzen 24 GB. Das Sprachmodell muss während des Laufs entladen
sein; mit OLLAMA_KEEP_ALIVE=0 aus der Einrichtung geschieht das nach jeder Antwort von selbst. Prüf vor dem Start mit
nvidia-smi, dass kein ollama-Prozess mehr Speicher belegt.